
Microsoft Outlook ponovno je pao i podsjetio svijet koliko moderni posao ovisi o jednoj kutiji elektroničke pošte.
U večeri 12. studenog 2026. korisnici diljem svijeta prestali su pristupati e-pošti preko web sučelja i preko aplikacija, a prve masovne prijave stigle su naglo.
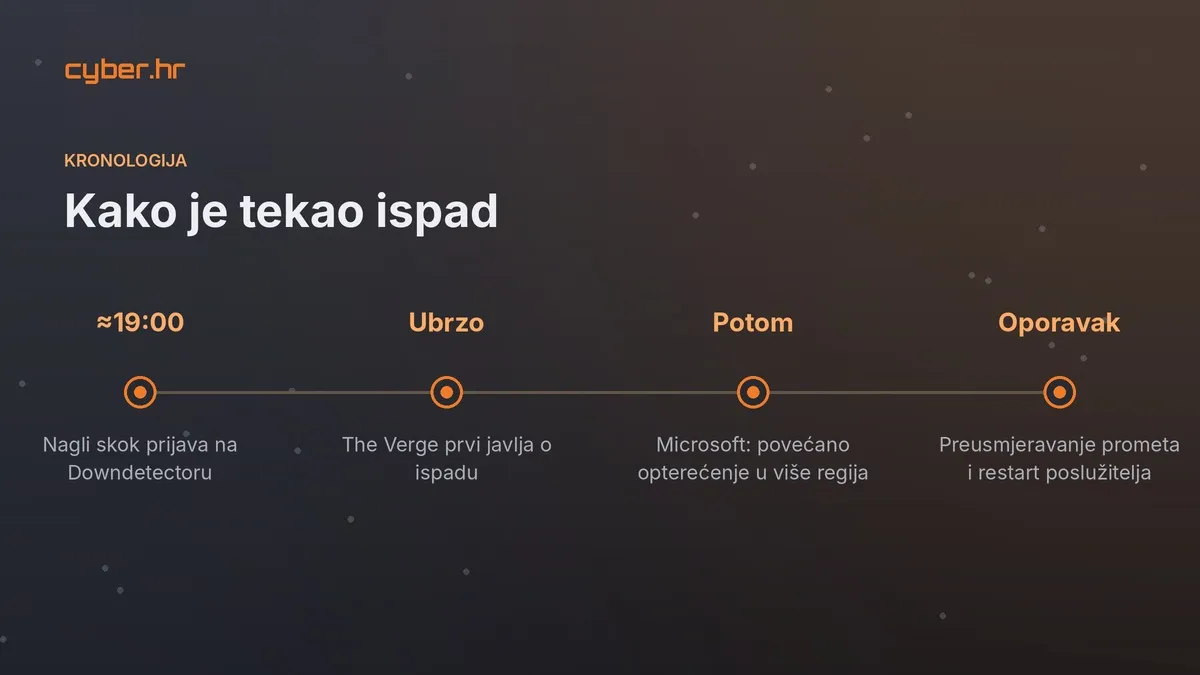
Broj prijava na servisu Downdetector skočio je neposredno prije 19 sati i nije se smirivao, dok su se i Microsoftove statusne stranice učitavale sporo.
Milijunima ljudi koji svoj radni dan drže u Outlooku, nekoliko sati bez pristupa pošti znači zaustavljene dogovore, propuštene rokove i tihu paniku oko toga je li problem do njih ili do Microsofta.
Incident sam po sebi nije bio dramatičan kao klasičan proboj podataka, no za sigurnosnu zajednicu puno je poučniji nego što se na prvi pogled čini.
Pokazuje koliko je poslovni svijet oslonjen na mali broj pružatelja usluga u oblaku, koliko slabo mnoge organizacije razlikuju kvar od napada, i koliko malo njih ima plan za trenutak kada temeljni alat jednostavno nestane.
U nastavku razlažemo što se dogodilo, kako je Microsoft reagirao, zašto ovakvi ispadi postaju sve češći i što iz svega toga trebaju naučiti i tvrtke i pojedinci.
Što se točno dogodilo
Kronologija je bila brza i prepoznatljiva svakome tko prati ovakve događaje.
Prijave su počele otprilike u sat vremena prije glavnih izvještaja, a nagli skok na Downdetectoru dogodio se neposredno prije 19 sati po lokalnom vremenu.
Prvi je o ispadu izvijestio The Verge, pozivajući se na korisničke prijave kroz prethodni sat.
U središtu problema bio je Outlook. Korisnici nisu mogli doći do e-pošte ni preko preglednika ni preko aplikacija, a problemi s pristupom pogodili su korisnike Microsoft 365 usluga diljem svijeta, osobito Outlook.
Zanimljivo je da nisu svi servisi pali jednako.
Za Teams je stiglo nešto prijava, no većina korisnika javljala je da im taj servis radi normalno.
Takva selektivnost, u kojoj jedan servis gotovo potpuno pada dok drugi radi, obično upućuje na problem u određenom sloju zajedničke infrastrukture, a ne na potpuni kolaps cijele platforme.
Opseg je bio globalan. Ispad je opisan kao svjetski, uz Microsoftovu tvrdnju da je dio infrastrukture bio pod povećanim opterećenjem u više regija.
Za razliku od lokaliziranih smetnji koje pogode samo jednu zemljopisnu regiju, ovaj je dotaknuo korisnike na više kontinenata istovremeno, što dodatno govori o tome da uzrok nije bio u pojedinačnom podatkovnom centru.
Microsoftov odgovor i mogući uzrok
Microsoftova komunikacija tekla je u koracima koje prate svi koji su ikad čekali oporavak neke usluge u oblaku.
U prvoj objavi na statusnom računu za Microsoft 365 kompanija je navela da je utvrdila da je dio infrastrukture pod povećanim opterećenjem u više regija, što je vjerojatno izazvalo probleme s povezivanjem.
Takva formulacija namjerno je oprezna, jer u ranoj fazi inženjeri još ne znaju je li riječ o pukom vršnom opterećenju ili o dubljem kvaru.
Microsoft Outlook dobio tehnički odgovor
Microsoft je kasnije poručio da je dovršio preraspodjelu prometa unutar svoje globalne infrastrukture i da preusmjerava dodatni promet dalje od pogođenih područja kako bi smanjio opterećenje, uz napomenu da ponovno pokreće pogođene poslužitelje kako bi ih vratio u funkciju.
Preraspodjela prometa i restart poslužitelja standardni su potezi u ovakvim situacijama, no oni sami po sebi otkrivaju da je problem bio sistemski, u načinu na koji mreža obrađuje i usmjerava zahtjeve.
Ključno pitanje ostalo je otvoreno.
Microsoft je istraživao je li povećani promet posljedica stvarnog porasta broja zahtjeva ili promjene u načinu na koji se promet usmjerava, pa uzrok u trenutku izvještavanja nije bio potvrđen.
Razlika između ta dva scenarija nije akademska. Ako je riječ o stvarnom skoku zahtjeva, govorimo o kapacitetu i planiranju opterećenja.
Ako je riječ o promjeni u usmjeravanju prometa, govorimo o konfiguraciji, dakle o ljudskoj ili automatiziranoj izmjeni koja je nenamjerno gurnula promet kroz pogrešne ili preopterećene putove.
www.index.hr
Taj drugi scenarij vrijedi istaknuti jer se ponavlja.
Pogrešne konfiguracijske promjene i neučinkovito usmjeravanje prometa stalni su okidači ovakvih ispada kod velikih pružatelja oblaka.
Veliki ispad Azure infrastrukture krajem listopada 2025. pripisan je upravo problematičnoj konfiguracijskoj promjeni primijenjenoj na dio Azure infrastrukture. O
brazac je jasan: što je sustav veći i složeniji, to jedna mala izmjena može imati nerazmjerno velike posljedice.
Nije svaki pad napad
Prva reakcija mnogih korisnika na ovakav ispad glasi da je Microsoft napadnut.
Takva pretpostavka razumljiva je, ali najčešće netočna.
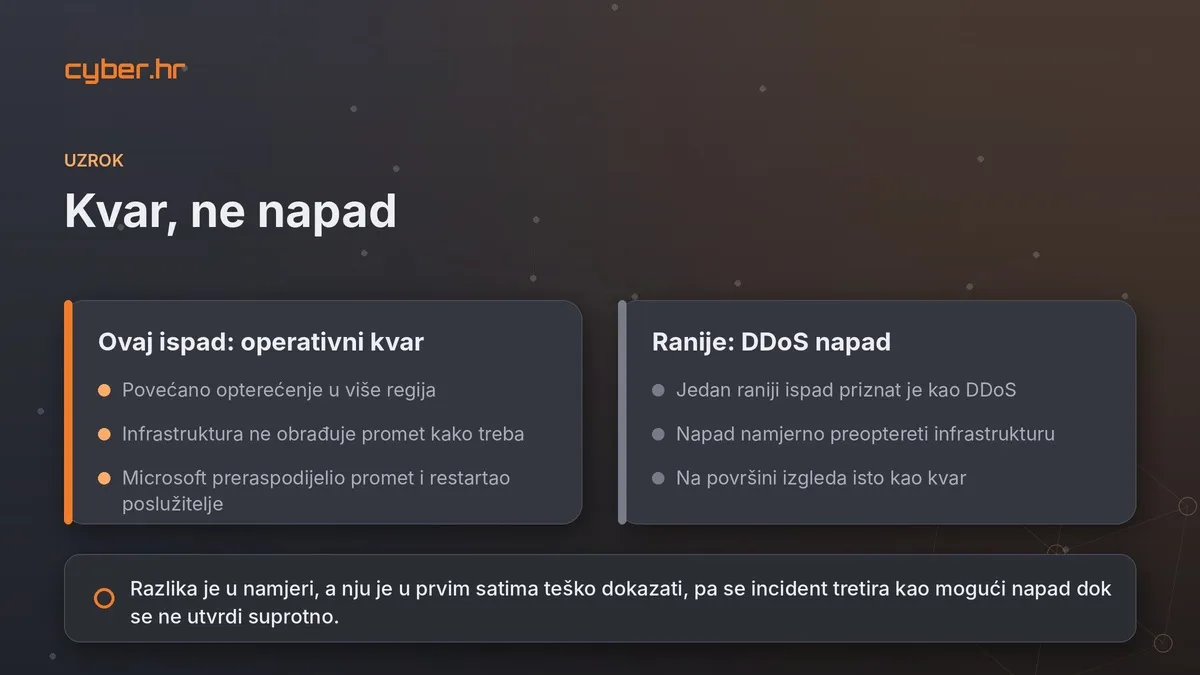
U ovom slučaju Microsoftova radna hipoteza bila je opterećenje i moguća promjena usmjeravanja prometa, dakle operativni kvar, a ne vanjski napad.
Oprez je ipak opravdan jer povijest pokazuje da granica nije uvijek jasna.
U jednom ranijem slučaju Microsoft Outlook je dan nakon devetosatnog ispada priznao da ga je izazvao distribuirani napad uskraćivanjem usluge, poznat kao DDoS. DDoS napad i nenamjerni skok prometa na površini izgledaju gotovo identično, jer oba preopterećuju infrastrukturu i obaraju servise.
Razlika je u namjeri, a nju je u prvim satima teško dokazati.
Zbog toga timovi za sigurnost ovakve događaje tretiraju kao potencijalni incident dok se ne utvrdi suprotno, a ne obrnuto.
Za sigurnosnu zajednicu tu leži prva pouka.
Dostupnost je dio sigurnosti, jednako kao povjerljivost i cjelovitost podataka.
Kada poslovno kritičan servis padne, posljedice po organizaciju mogu biti jednako ozbiljne kao kod proboja, bez obzira na to što podaci nisu ukradeni.
Zaustavljena komunikacija, nedostupni ugovori i prekinuti radni tokovi izravno pogađaju poslovanje, a produljeni ispad stvara idealan teren za sekundarne napade o kojima će biti riječi kasnije.
Oblak kao jedinstvena točka ispada
Pravi razlog zašto ovakav ispad odjekuje daleko izvan Microsofta leži u koncentraciji.
Golem dio svjetskog poslovanja oslanja se na mali broj pružatelja usluga u oblaku, a unutar tog kruga Microsoft Outlook drži enormno velik udio poslovne e-pošte, dokumenata i komunikacije.
Kada takva platforma posrne, posljedice se istovremeno osjete u bolnicama, bankama, školama, javnoj upravi i tvrtkama svih veličina.
Analitičari na to gledaju bez uljepšavanja.
Višesatni ispad servisa kao što je Microsoft Outlook, Teamsa i SharePointa, kako je ocijenio analitičar Manish Rawat iz TechInsightsa, obično signalizira ozbiljan poremećaj u temeljnoj Microsoftovoj infrastrukturi oblaka.
Drugim izrazom, kada padne jedan sloj te infrastrukture, pada i niz naizgled nepovezanih usluga, jer sve dijele iste temelje.
computerworld
Riječ je o klasičnoj jedinstvenoj točki ispada, samo na globalnoj razini.
Organizacije godinama grade redundanciju unutar vlastitih sustava, a onda cijelo poslovanje stave na jednu vanjsku platformu bez rezervnog plana.
Dok platforma radi, takva centralizacija donosi ogromnu učinkovitost i uštede. Kada platforma padne, ista ta centralizacija pretvara lokalni tehnički kvar u globalni poslovni zastoj.
Loša godina za Microsoftov oblak
Ispad od 12. studenog nije se dogodio u vakuumu.
Pratio je niz sličnih smetnji koje su obilježile cijelu 2026. godinu i učinile je jednom od težih u novijoj povijesti Microsoftovih usluga u oblaku.
Godina je loše počela. Krajem siječnja 2026. Microsoft 365 pogodio je ispad koji se protegnuo na gotovo deset sati tijekom loše noći za sjevernoameričku infrastrukturu, a na vrhuncu je Downdetector zabilježio oko 15.000 prijava.
Microsoft je tada okrivio dio uslužne infrastrukture u Sjevernoj Americi koji nije obrađivao promet onako kako se očekivalo.
Formulacija je gotovo identična onoj iz studenog, što govori o ponavljajućem uzorku.
Uzorak se nastavio kroz godinu, uz opetovane smetnje s istim tehničkim potpisom.
Tijekom 2026. zabilježeni su i ispadi u travnju, kada korisnici nisu mogli pristupiti većem broju Microsoft 365 usluga, uključujući Teams i Outlook, uz uzroke vezane uz infrastrukturu koja nije učinkovito obrađivala promet.
Ponavljanje istog obrasca kroz više mjeseci upućuje na to da nije riječ o nizu nesretnih slučajnosti, nego o strukturnom izazovu održavanja goleme i rastuće globalne infrastrukture.
isdown
Ispadi ovakve vrste nisu jednokratna anomalija koju treba otrpjeti i zaboraviti.
Postaju predvidiv dio krajolika, pa ih treba tretirati kao rizik koji se planira, a ne kao iznenađenje koje se svaki put iznova doživljava kao šok.
Phishing i socijalni inženjering
Ovdje priča postaje izravno sigurnosna.
Svaki veliki i javno poznat ispad stvara savršen zaklon za napadače, jer u tim satima vlada zbunjenost, nestrpljenje i snižena budnost.
Dok korisnici grozničavo traže način da se vrate pošti, kriminalci nude lažna rješenja.
Tipičan scenarij izgleda ovako.
U jeku ispada pojave se poruke i objave koje tvrde da nude obnovu pristupa, hitnu prijavu na novi portal ili provjeru računa zbog navodnog sigurnosnog incidenta.
Lažne stranice za prijavu, dizajnirane da izgledaju kao Microsoftove, prikupljaju korisnička imena, lozinke i kodove za dvofaktorsku autentifikaciju od ljudi koji su previše uznemireni da bi provjerili adresu stranice.
Napadač se oslanja na to da žrtva želi vjerovati kako je pronašla način da zaobiđe ispad.
Postoji i druga opasnost, odgođena u vremenu.
Kada se pošta nakon ispada vrati, stiže velika količina zaostalih poruka odjednom.
U toj poplavi lakše prolaze zlonamjerni privici i poveznice, jer korisnici brzo prebiru nagomilanu poštu i manje pažljivo provjeravaju pošiljatelja.
Napadači znaju da je razdoblje neposredno nakon oporavka jednako osjetljivo kao i sam ispad.
Komunikacija tijekom ispada mora teći provjerenim kanalima, a zaposlenike treba unaprijed podsjetiti da Microsoft tijekom smetnji neće tražiti lozinke niti nuditi čarobne poveznice za obnovu pristupa.
Jedno kratko, unaprijed pripremljeno upozorenje poslano alternativnim kanalom može spriječiti niz kompromitiranih računa.
Moramo biti spremni
Ispad poput ovoga nije moguće spriječiti s korisničke strane, jer uzrok leži u Microsoftovoj infrastrukturi.
Moguće je, međutim, pripremiti se tako da ispad bude neugodnost, a ne kriza.
Otpornost se ne gradi tijekom pada, nego prije njega.
Korisne mjere
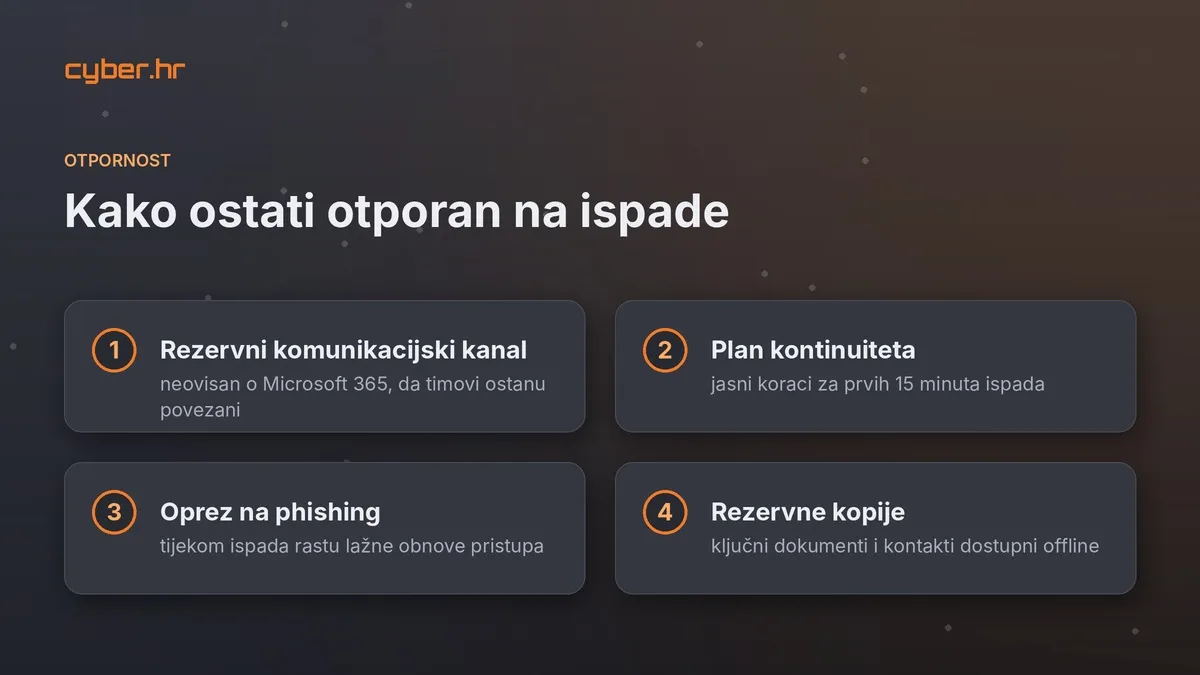
- Rezervni komunikacijski kanal.
Svaka organizacija treba unaprijed dogovoren način komunikacije koji ne ovisi o Microsoft 365, primjerice zasebni servis za poruke ili e-poštu na drugoj domeni, kako bi timovi ostali povezani i kada Outlook i Teams nisu dostupni.
- Plan kontinuiteta poslovanja s jasnim koracima.
Zaposlenici trebaju znati što raditi u prvih petnaest minuta ispada, kome se javiti i gdje provjeriti službeni status, bez pogađanja i bez širenja panike.
- Praćenje službenih izvora.
Microsoftova statusna stranica i administratorski centar s identifikatorom incidenta pouzdaniji su od glasina na društvenim mrežama, pa IT timovi trebaju pratiti upravo njih za potvrđene informacije.
- Rezervne kopije i izvoz ključnih podataka.
Lokalno dostupne kopije najvažnijih dokumenata i kontakata omogućuju nastavak rada i kada je oblak nedostupan.
Reagirajte
I pojedinačni korisnici mogu ublažiti posljedice ovakvih ispada bez posebnog tehničkog znanja.
- Prvi je korak mentalni: kada Outlook stane, vrijedi najprije provjeriti je li riječ o globalnom ispadu, a ne trošiti sate na ponovno pokretanje uređaja i mijenjanje postavki.
Provjera neovisnog servisa za praćenje smetnji i Microsoftove statusne stranice brzo daje odgovor.
- Drugi je korak otpor nagonu da se problem riješi klikom na prvu ponuđenu poveznicu.
Nijedan legitiman način obnove pristupa neće stići kroz sumnjivu poruku ili nepoznatu stranicu za prijavu.
Strpljenje je tijekom ispada najbolja zaštita, jer servisi se gotovo uvijek vrate sami, a većina šteta nastaje upravo iz ishitrenih poteza.
- Treći je korak priprema za normalne dane.
Povezivanje važnih kontakata i dokumenata s alternativnim pristupom, te povremeni izvoz ključne pošte, znače da ispad ne zaustavlja privatni ili poslovni život u potpunosti.
Male navike, stečene dok sve radi, isplate se upravo u trenucima kada ne radi.
Zaključak
Microsoft je preraspodijelio promet, ponovno pokrenuo pogođene poslužitelje i istraživao je li uzrok stvarni porast zahtjeva ili promjena u usmjeravanju prometa.
Ipak, iza te rutine krije se ozbiljnija poruka.
Svaki ovakav ispad podsjetnik je da je dostupnost dio sigurnosti, da je koncentracija poslovanja na nekoliko platformi stvaran rizik, i da kaos oko ispada otvara vrata napadačima jednako pouzdano kao i svaka ranjivost u kodu.
Organizacije koje to shvate gradit će otpornost prije sljedećeg pada, a ne nakon njega. Jer sljedeći pad nije pitanje hoće li se dogoditi, nego kada, i zateći će pripremljene i nepripremljene u vrlo različitim pozicijama.


